En juin 2026, Snowflake et Databricks ont tenu leurs grandes conférences annuelles à quelques jours d’intervalle. Les deux éditeurs se livrent une concurrence frontale, et pourtant leurs annonces racontent la même histoire : la plateforme de données devient la plateforme des agents IA. Et ce qui fait la différence n’est plus le modèle, mais le contexte métier et les garde-fous qui l’entourent. Décryptage, et ce que cela implique pour vos projets.
Snowflake : des agents pour les métiers
- CoWork, évolution de Snowflake Intelligence, est présenté comme un agent personnel pour les collaborateurs : il interroge les données, produit des analyses et des tableaux de bord, et interagit avec les outils du quotidien.
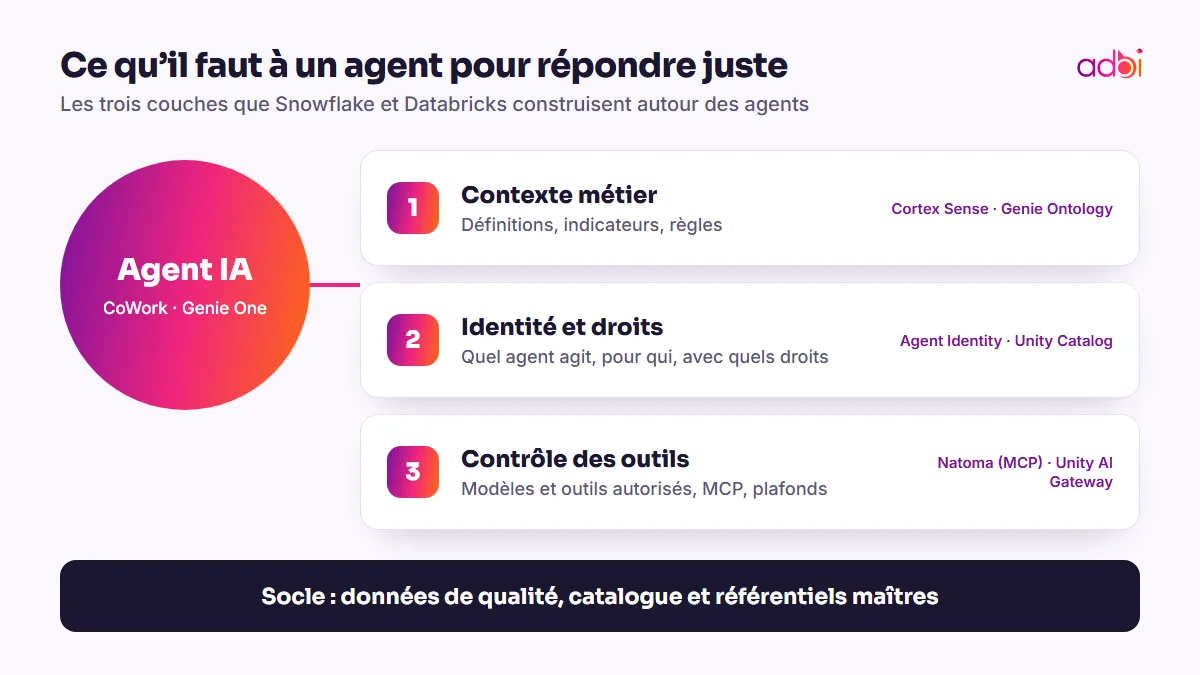
- Cortex Sense apporte automatiquement aux agents la compréhension des règles métier, des définitions, des indicateurs et des relations entre les données, à partir de signaux déjà présents dans la plateforme.
- Une identité pour chaque agent : chaque agent reçoit une identité vérifiée et ses actions sont tracées. Il ne suffit plus de savoir quel utilisateur accède à quelles données, il faut savoir quel agent agit, pour le compte de qui et avec quels droits.
- Le rachat de Natoma, spécialiste de la sécurisation des connexions MCP, le protocole devenu le standard de fait pour brancher les agents sur des applications externes.
Databricks : des agents gouvernés de bout en bout
- Genie One, l’assistant de Databricks, est annoncé comme généralement disponible, connecté à de nombreuses applications de travail. Il s’appuie sur Genie Ontology, une couche de contexte qui donne aux agents les définitions métier.
- Agent Bricks est étendu, avec le choix entre plusieurs familles de modèles, une mémoire gérée pour les agents et des environnements d’exécution isolés.
- Unity AI Gateway devient la couche de gouvernance des agents, des modèles, des connexions MCP et des outils, rattachée à Unity Catalog, avec notamment des plafonds de dépense. Certaines de ces briques sont encore en préversion : vérifiez leur disponibilité avant de bâtir un projet dessus.
À retenir : les deux éditeurs construisent la même chose : une couche de sens (définitions, indicateurs, règles), une identité et des droits pour chaque agent, et un point de contrôle unique pour les modèles et les outils.
Pourquoi cette convergence ?
Les premiers agents conversationnels sur la donnée ont montré leurs limites : ils répondent avec assurance, mais pas toujours juste. La cause est rarement le modèle. C’est le plus souvent le contexte qui manque : un « chiffre d’affaires » qui n’a pas la même définition selon les équipes, une table client en doublons, un indicateur calculé de trois façons différentes.
Les éditeurs l’ont compris : la course ne se joue plus sur le modèle, que tout le monde peut appeler, mais sur la qualité du contexte fourni et sur la maîtrise de ce que l’agent a le droit de faire.
Ce que cela change pour vos projets
Les définitions métier deviennent un actif
Un glossaire métier, un catalogue de données et une couche sémantique documentée étaient vus comme des chantiers de gouvernance « pour plus tard ». Ils deviennent la matière première des agents. Des outils comme DataGalaxy ou les catalogues intégrés aux plateformes prennent ici tout leur sens.
La qualité des données redevient prioritaire
Un agent qui lit des données fausses prend de mauvaises décisions, plus vite. Contrôles automatiques, qualité des données et référentiels maîtres sont les garde-fous les plus efficaces.
Les agents doivent être gérés comme des utilisateurs
Droits minimaux, traçabilité des actions, plafonds de coût, validation humaine pour les opérations sensibles : ce sont les mêmes principes que pour un compte de service, appliqués à une entité beaucoup plus autonome.
| Besoin de l’agent | Côté Snowflake | Côté Databricks | Ce que vous devez préparer |
|---|---|---|---|
| Contexte métier | Cortex Sense | Genie Ontology | Glossaire, définitions d’indicateurs |
| Identité et droits | Identité des agents | Unity Catalog | Politique d’accès par agent |
| Contrôle des modèles et outils | Sécurisation MCP (Natoma) | Unity AI Gateway | Liste des outils autorisés, plafonds |
| Interface métier | CoWork | Genie One | Cas d’usage prioritaires, tests |
Notre conseil : commencer par un cas d’usage borné
Plutôt que d’ouvrir un agent sur toute la plateforme, choisissez un domaine où les définitions sont stables et les données fiables : suivi commercial, logistique, finance. Documentez les indicateurs, testez l’agent sur des questions dont vous connaissez la réponse, puis élargissez. C’est plus lent la première semaine, et beaucoup plus rapide ensuite.
Questions fréquentes
Faut-il choisir entre Snowflake et Databricks pour faire des agents ?
Non. Les deux proposent des briques comparables. Le bon choix dépend de votre existant, de vos compétences et de vos usages. Notre approche est agnostique : nous partons de vos données, pas d’un éditeur.
Un agent peut-il fonctionner sans catalogue de données ?
Techniquement oui, mais ses réponses seront moins fiables. Un catalogue, même léger, sur le périmètre de l’agent améliore nettement la qualité des réponses.
Qu’est-ce que MCP ?
Le Model Context Protocol est un protocole ouvert qui permet de brancher un agent IA sur des outils et des applications. Il est devenu le standard de fait, d’où l’importance de sécuriser ces connexions.
Vous voulez déployer des agents IA sur vos données en gardant la maîtrise ? Découvrez notre approche des agents et de l’IA générative, notre partenariat Snowflake, ou parlons de votre projet.
Sources
Pour aller plus loin : Data Integration →