Le 6 octobre 2026, Mistral AI a dévoilé Mistral Large 4, son nouveau modèle phare. Quelques semaines plus tôt, l’entreprise française avait levé 3 milliards d’euros, pour une valorisation de plus de 21 milliards. Au-delà de la bataille des classements, cette annonce pose une question très concrète pour les entreprises européennes : quel modèle utiliser, pour quels usages, et avec quelle maîtrise de ses données ?
Ce qui a été annoncé
- Un très grand modèle : Mistral Large 4 compte environ 1 000 milliards de paramètres. Il repose sur un « mélange d’experts » : seule une partie du modèle, de l’ordre de 50 milliards de paramètres, travaille pour chaque requête.
- Des poids ouverts (« open weight ») : les paramètres et l’architecture doivent être rendus publics, ce qui permet en principe d’héberger le modèle soi-même.
- Un accès progressif : le modèle est d’abord proposé en préversion par API, les poids étant promis pour la fin du mois d’octobre. À la mi-octobre, ni les poids ni la licence n’étaient encore publiés : vérifiez les conditions d’usage avant tout projet commercial.
L’objectif affiché est de revenir au niveau des meilleurs modèles américains et chinois. Les comparatifs indépendants prendront quelques semaines : mieux vaut attendre des évaluations sur vos propres cas d’usage que de se fier aux annonces.
À retenir : « poids ouverts » ne veut pas dire « facile à héberger ». Un modèle de cette taille demande une infrastructure de calcul conséquente. Pour beaucoup d’entreprises, l’enjeu sera surtout de pouvoir choisir où il tourne.
Pourquoi c’est important pour les entreprises
La maîtrise des données
Un modèle à poids ouverts peut être déployé chez un hébergeur européen, dans un cloud privé ou sur une infrastructure interne. Pour les données confidentielles (contrats, données RH, données de santé, secrets industriels), c’est souvent la condition pour passer d’un pilote à la production.
La réversibilité
Dépendre d’un seul fournisseur de modèle est un risque : changement de prix, de conditions, de disponibilité. Disposer d’alternatives crédibles et européennes rééquilibre la négociation et permet de construire des architectures où le modèle est un composant remplaçable.
La conformité
Avec l’AI Act, les fournisseurs de modèles à usage général ont des obligations de documentation. Savoir précisément quel modèle est utilisé, dans quelle version et où, fait partie de la traçabilité attendue. Nous détaillons le calendrier dans notre article AI Act : ce que change l’omnibus numérique.
Choisir ses modèles : notre méthode
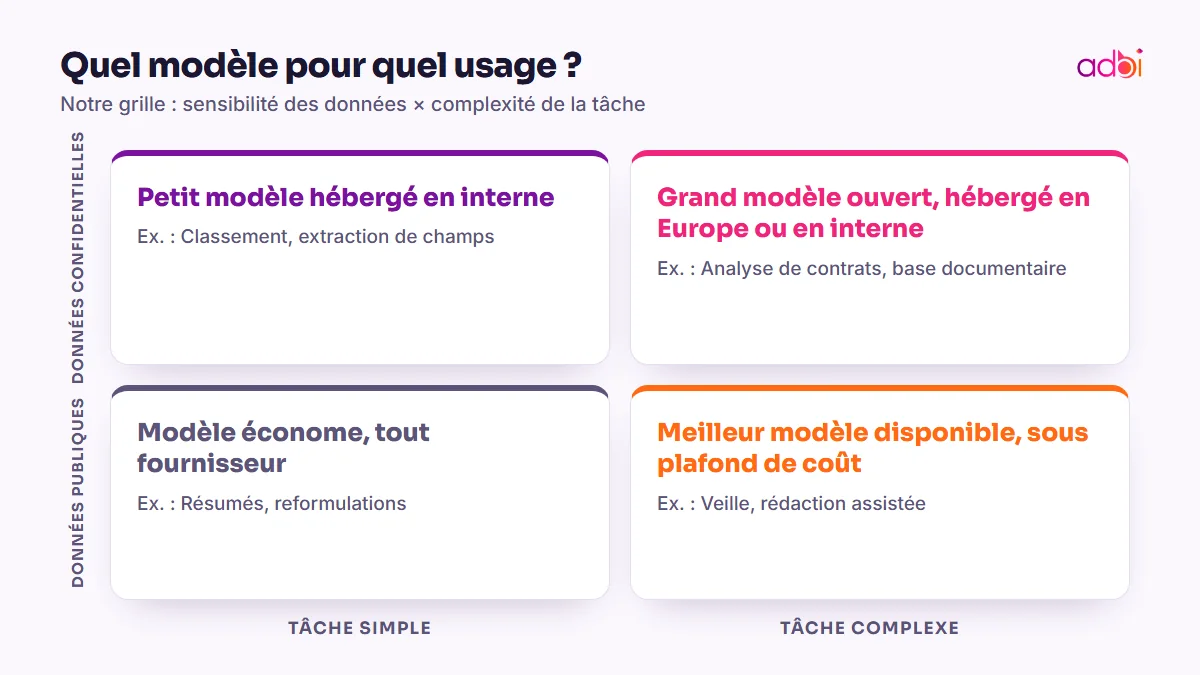
Sur le terrain, nous ne recommandons jamais « le meilleur modèle » dans l’absolu. Nous aiguillons chaque cas d’usage vers le modèle adapté selon deux critères : la sensibilité des données et la complexité de la tâche.
| Situation | Type de modèle conseillé | Exemple |
|---|---|---|
| Données confidentielles, tâche simple | Petit modèle hébergé en interne | Classement de courriels, extraction de champs |
| Données confidentielles, tâche complexe | Grand modèle ouvert, hébergé en Europe ou en interne | Analyse de contrats, assistant sur la base documentaire |
| Données publiques, tâche simple | Modèle économe, quel que soit le fournisseur | Résumés, reformulations |
| Données publiques, tâche complexe | Meilleur modèle disponible, sous plafond de coût | Veille, rédaction assistée |
Trois règles complètent ce tableau :
- Évaluer sur vos données. Constituez un jeu de questions et de réponses attendues, et comparez les modèles dessus. C’est le seul classement qui compte pour vous.
- Prévoir un repli. Un modèle indisponible ne doit pas bloquer un processus métier : une passerelle d’IA permet de basculer vers une alternative.
- Mesurer les coûts. Les très grands modèles sont plus chers à l’usage. Réservez-les aux tâches qui le justifient.
Le vrai sujet reste la donnée
Un modèle plus puissant ne corrige pas une base documentaire mal tenue ni un référentiel client en doublons. Dans les projets d’IA générative que nous menons, l’essentiel de l’effort porte sur la préparation et la gouvernance des données : c’est ce que nous appelons la donnée prête pour l’IA. C’est aussi la condition pour faire parler vos documents avec l’IA sans perdre la maîtrise des accès.
Questions fréquentes
Peut-on utiliser Mistral Large 4 dès maintenant ?
Oui, en préversion par l’API de Mistral. L’hébergement par vos soins dépendra de la publication des poids et de la licence retenue.
Faut-il remplacer nos modèles actuels ?
Pas sans évaluation. Si vos cas d’usage fonctionnent, comparez d’abord sur vos propres données, en tenant compte du coût et de l’hébergement.
Un modèle européen garantit-il la confidentialité ?
Non, c’est le lieu et les conditions d’hébergement qui la garantissent. Un modèle ouvert vous donne la possibilité de choisir ces conditions.
Vous voulez mettre l’IA générative en production en gardant la main sur vos données ? Découvrez notre approche de l’IA générative ou parlons de votre projet.
Sources
Pour aller plus loin : Intelligence artificielle : stratégie, IA générative et agents →