Le 16 octobre 2026, Snowflake a annoncé la disponibilité générale de la mise à niveau de ses tables Apache Iceberg vers la version 3 du format, ainsi que des valeurs par défaut d’expression pour ces tables. Pour les équipes qui bâtissent un lakehouse ouvert, c’est une étape de maturité : une table existante peut évoluer sans être recréée.
Ce qui est disponible
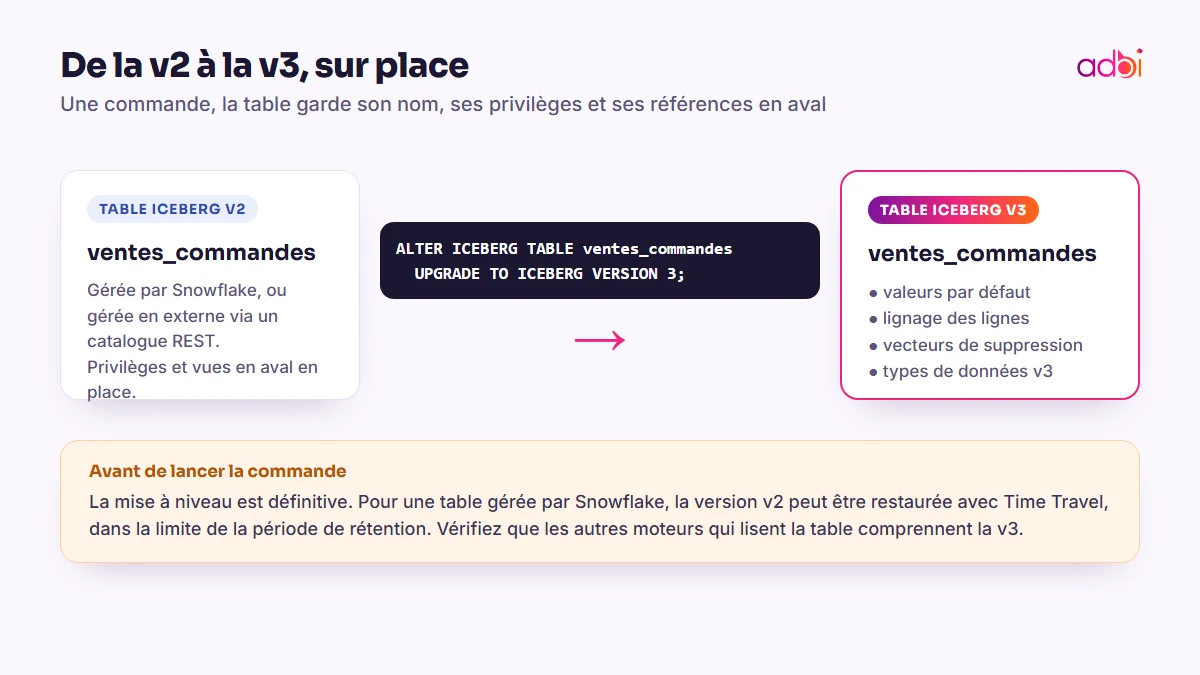
- Une mise à niveau sur place : la commande `ALTER ICEBERG TABLE … UPGRADE TO ICEBERG VERSION 3` fait passer une table de la version 2 à la version 3. La table conserve son nom, ses privilèges et ses références en aval : il n’est pas nécessaire de la recréer.
- Des fonctionnalités de la version 3 : valeurs par défaut, lignage des lignes (*row lineage*), vecteurs de suppression (*deletion vectors*) et types de données de la version 3.
- Deux familles de tables concernées : les tables gérées par Snowflake, et les tables gérées en externe avec `CATALOG_SOURCE = ICEBERG_REST`, y compris dans les bases de données liées à un catalogue.
- Des valeurs par défaut d’expression : les tables v3 gérées par Snowflake acceptent des expressions SQL, des séquences et des colonnes d’identité comme valeurs par défaut de colonne, comme en version 2.
À retenir : la mise à niveau est définitive. Pour une table gérée par Snowflake, la version 2 d’origine peut être restaurée avec Time Travel, dans la limite de la période de rétention.
Les valeurs par défaut d’expression, en détail
Deux cas se distinguent, selon la nature de l’expression :
| Type de valeur par défaut | Exemple | Comportement |
|---|---|---|
| Expression évaluable en constante | `PI()` | Snowflake l’écrit dans les métadonnées Iceberg |
| Autre expression, séquence ou colonne d’identité | `CURRENT_DATE()` | Évaluée uniquement pour les écritures effectuées par Snowflake ; nécessite le nouveau paramètre `ALLOW_V3_EXPRESSION_DEFAULTS` |
Lorsqu’une table v2 qui porte déjà des valeurs par défaut d’expression est mise à niveau, Snowflake active automatiquement ce paramètre sur la table.
Pourquoi cela compte pour votre architecture
Notre lecture : Iceberg est un format de table ouvert, conçu pour que plusieurs moteurs lisent et écrivent les mêmes données. Une table qui peut passer en version 3 sans être recréée simplifie l’évolution d’un lakehouse déjà en production. Mais un format ouvert ne vaut que par l’ensemble des moteurs qui le comprennent : avant de mettre à niveau, il faut savoir qui lit vos tables.
Comment aborder la mise à niveau
1. Inventoriez vos tables Iceberg et leurs lecteurs : moteurs de requête, outils de BI, traitements externes. Vérifiez, moteur par moteur, la prise en charge de la version 3. 2. Commencez par une table peu critique, et validez les lectures et les écritures avant de généraliser. 3. Testez les valeurs par défaut non constantes : elles ne sont évaluées que pour les écritures faites par Snowflake. Un autre moteur qui écrit dans la table ne les appliquera pas. 4. Documentez la décision et la date : la mise à niveau étant définitive, mieux vaut la tracer dans votre catalogue de données.
Ce que la note ne précise pas
La note de version ne donne ni tarification, ni régions concernées, ni liste complète des limites techniques au-delà de celles citées ci-dessus. Pour un projet, consultez la documentation « Upgrade an Apache Iceberg table from version 2 to version 3 » de Snowflake.
Questions fréquentes
Faut-il recréer mes tables pour passer à la version 3 ?
Non. La mise à niveau se fait sur place : la table garde son nom, ses privilèges et ses références en aval.
Peut-on revenir à la version 2 ?
La mise à niveau est définitive. Pour une table gérée par Snowflake, la table v2 d’origine peut être restaurée avec Time Travel, dans la limite de la période de rétention.
Les autres moteurs liront-ils mes tables en version 3 ?
Cela dépend de leur prise en charge de la version 3 du format. Vérifiez-la moteur par moteur avant de mettre à niveau.
Vous construisez ou faites évoluer un lakehouse ouvert ? Notre audit évalue votre architecture de données et vos formats de table. Parlons de votre plateforme.
Sources
Pour aller plus loin : Data Integration →